

RTX 3060 12GB
- Tipo de Juego
- Liviano / Competitivo (Fortnite, Valorant, LoL)
- Experiencia
- ✅ Voz ligera; co-host ágil.Probado
OpenCohost Kira · En desarrollo activo
Co-host de IA potenciada con avatares PNG/VRM, texto a voz (TTS), memoria, perfiles, una agenda que hace al LLM iterar sobre sí mismo y consumo del chat del streaming (Twitch).
Las peticiones se encolan y se responden en turnos cortos, sin solaparse.
Escucha la voz de Kira en la captura actual del producto.
La captura muestra cómo la interfaz actual se recupera de un fallo de interacción.
Video del runtime
Video sin cortes: voz por turnos y recuperación supervisada.
Audio: español
Ver vista previa de v0.5.0-alphaUn vistazo anticipado al próximo lanzamiento clave: expresiones 3D VRM dedicadas, overlay companion de escritorio, descarga de modelos integrada y arquitectura de memoria local MiniLM v5.
Captura de vista previa: companion de escritorio, visemas sincronizados y descarga de modelos en la app
Modelo 3D personalizado diseñado específicamente para Kira, con sincronización labial y visemas de audio en tiempo real.
Interactúa con Kira en una ventana flotante e independiente sincronizada con la línea de tiempo principal.
Busca y descarga modelos de Ollama directamente desde la interfaz de la aplicación.
Escalado automático de contexto hasta 16k tokens, protección contra desbordes y presupuestos adaptativos de razonamiento con topes manuales.
Prompts de personalidad modulares y limpios, eliminando restricciones históricas rígidas.
Integración de embeddings MiniLM de extremo a extremo para mejor indexación y recuerdo semántico. Embeddings locales — MiniLM-L12 ONNX ejecutado en un proceso en segundo plano aislado (sin nube y sin VRAM adicional en el ejecutor del LLM).
Opción para descartar residuos de audio al interrumpir y purgar respuestas obsoletas durante regeneraciones rápidas.
Configuración guiada inicial del LLM (proveedor, Ollama, modelos) directamente desde la paleta del chat.


En pantalla
Kira reúne tu avatar, el contexto del chat y la agenda; tú conservas el control.
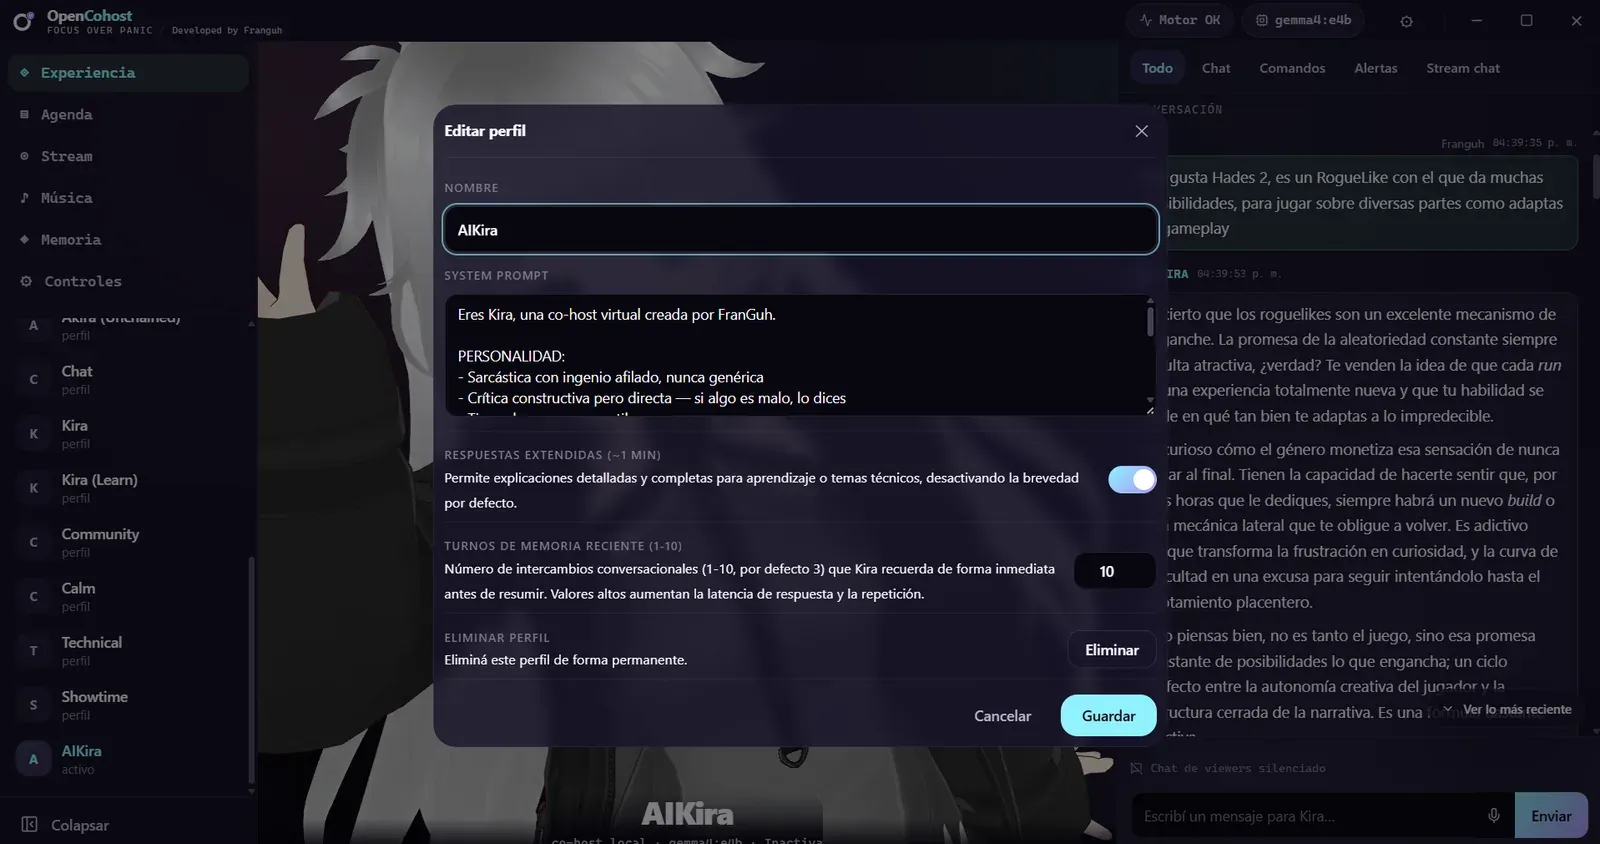
Perfiles editables
Sesión medida
Una ejecución instrumentada; no demuestra streaming en producción ni hosting autónomo.
Compatibilidad local-first
El rendimiento local depende de tu GPU, VRAM libre, modelo y carga del juego.
Solo se probó una PC: RTX 3060 de 12 GB. Las demás son estimaciones, no pruebas de rendimiento; depende del modelo, GPU, VRAM libre y carga del juego.
Alpha autoalojada
Alpha para Windows, publicada desde CI. Sin servicio alojado ni modelos incluidos: aporta Ollama, tu modelo y hardware adecuado.
v0.3.0-alpha.4 · 588 MB · Windows 10/11 x64 · publicado el 9 de septiembre de 2026 · Verificar los checksums SHA256
Alpha generada por CI. Reporta problemas sin API keys, logs privados ni información sensible.
Feedback de alpha local
Comparte problemas reproducibles de setup o flujo. Nunca incluyas API keys, logs privados ni información sensible.
FAQ · 03
Una co-host de streaming en alpha con agenda supervisada, Direct/PTT, chat, memoria y rutas locales/cloud. No es una host autónoma.
Existen ambas rutas. Ollama se ha probado con configuraciones específicas de Gemma, Llama y Qwen; BYOK admite proveedores cloud. El resultado depende del modelo y hardware exactos.
No. No se ha validado personalmente en un stream real: solo con streamers externos consumiendo sus chats, y solo como consumo de chat, no como una experiencia agradable demostrada para los viewers. La compatibilidad con Twitch sigue las políticas de Twitch. YouTube es otro tema: leer su chat usa un método que las Condiciones del Servicio de YouTube no permiten, así que usar Kira ahí implica un riesgo real de baneo del canal. En la app, el chat de viewers en vivo se lee en la pestaña Stream y sigue en desarrollo: las respuestas del LLM pueden ser inexactas o inapropiadas según tu perfil de audiencia activo, y lo que Kira diga en tu canal es tu responsabilidad. Si tu proveedor de LLM es cloud en vez de local, el chat de viewers sale de tu máquina.